وقتی یک مدل هوش مصنوعی عمومی را برای کارهای تخصصی یا تجاری آزمایش میکنید، خیلی زود متوجه یک شکاف بزرگ میشوید؛ این مدلها کلیات را عالی میفهمند، اما در درک جزئیات عمیق، اصطلاحات فنی یا دادههای بومی لنگ میزنند. برای حل این چالش، فرایندی به نام Fine-tuning معرفی شده است. اکنون میخواهیم بدانیم که فاین تیونینگ چیست و چگونه میتواند یک مدل خام را به متخصصی تمامعیار برای کسبوکار ما تبدیل کند.
فاین تیونینگ (Fine-tuning) یا تنظیم دقیق، فرایندی است که در آن یک مدل ازپیشآموزشدیده را با دادههای اختصاصی بازآموزی میکنیم تا برای انجام وظایفی مشخص بهینهسازی شود. در این مقاله، این مفهوم کلیدی را توضیح خواهیم داد و درباره نحوه کارکرد و روشهای کارآمدی مثل PEFT تا تحلیل مزایا، هزینهها و چالشهای پیادهسازی آن روی مدلهای زبان فارسی نیز صحبت میکنیم.
جدول محتواها
فاین تیونینگ چگونه کار میکند؟
برای درک بهتر این مفهوم، ابتدا باید بدانید که اکثر مدلهای هوش مصنوعی بزرگ (مانند LLMها)، کار خود را با پیشآموزش» (Pre-training) شروع میکنند. آنها اقیانوسی از دادههای عمومی وب را تحلیل میکنند تا ساختار زبان و منطق کلی جهان را یاد بگیرند. اما این دانش عمومی معمولاً برای کارهای حساس و تخصصی کافی نیست.
فاین تیونینگ مدل یعنی برداشتن همین مدلِ همهچیزدان عمومی و بازآموزی (Retraining) آن با یک مجموعه داده (Dataset) کوچکتر، هدفمندتر و کاملاً تخصصی. بااینکار، بدون اینکه نیاز باشد میلیاردها تومان هزینه کنید و یک مدل را از صفر بسازید، رفتار و خروجی هوش مصنوعی را برای نیازهای دقیق خود شخصیسازی میکنید.
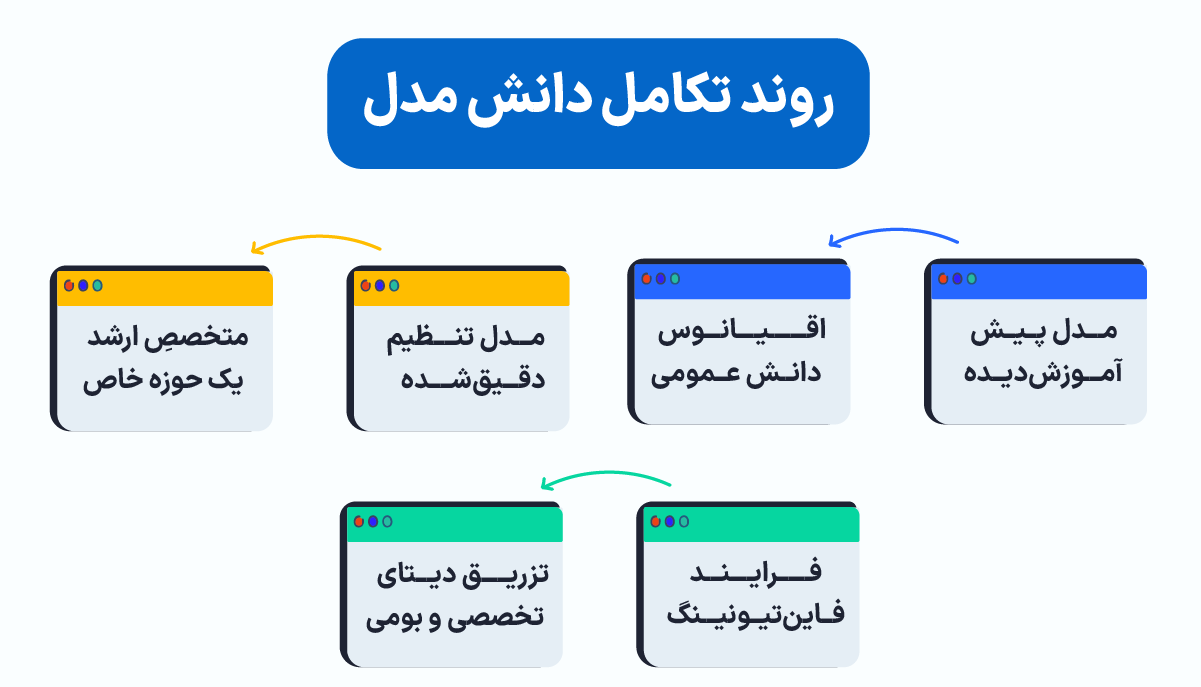
یک مثال ملموس برای درک فرایند
شخصی فارغالتحصیل رشته پزشکی را درنظر بگیرید که ساختار کلی بدن انسان، بیماریهای عمومی و داروها را کاملاً میشناسد. اگر این شخص را به مدت چند ماه در یک بخش فوقتخصصی قلب و عروق قرار دهید و تمام زمانش را صرف مطالعه پروندههای بیماران قلبی کند، او تخصص جدیدی کسب میکند.
فاین تیونینگ در هوش مصنوعی نیز دقیقاً به همین معنا است:
- مدل پایه (Pre-trained): همان فارغالتحصیل پزشکی با دانش عمومی است.
- دادههای تخصصی (Dataset): پروندههای بیماران قلبی است.
- نتیجه فاینتیونینگ: یک دستیار هوش مصنوعی فوقتخصص است که اصطلاحات، الگوها و نیازهای آن حوزه را با کمترین خطای ممکن درک میکند.
مراحل فاین تیونینگ مدل (پایپلاین عملیاتی ۶ مرحلهای)
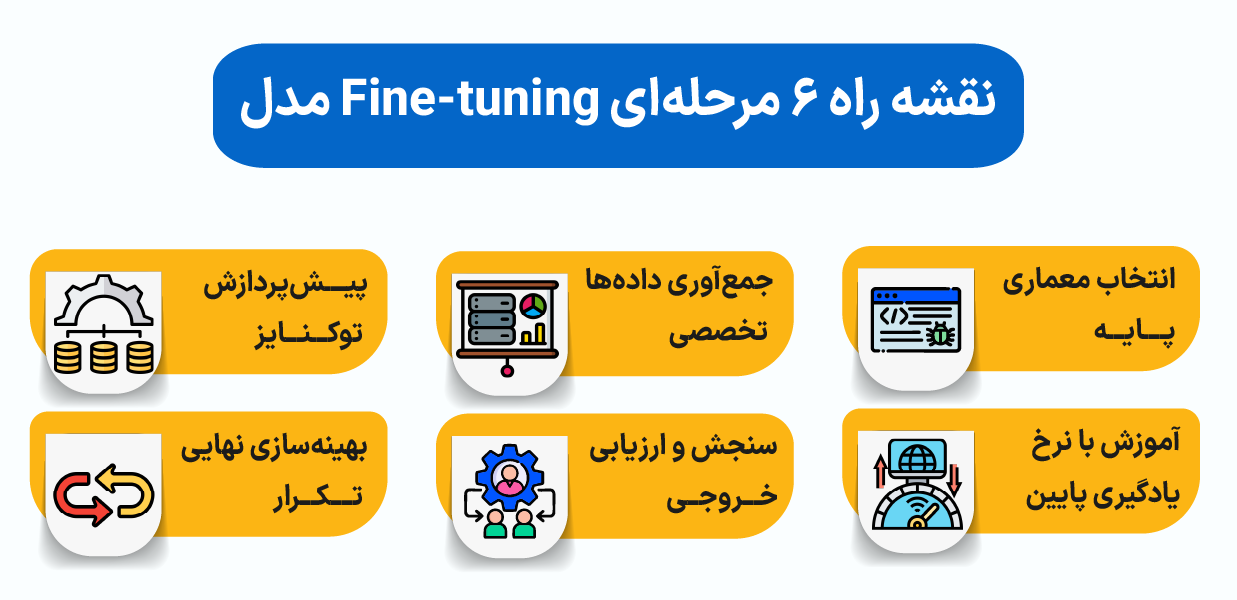
وقتی از فاز تئوری خارج میشویم و میخواهیم پاسخ روشنی به فاین تیونینگ چیست بدهیم، باید یک نقشه راه منظم داشته باشیم. این فرایند یک چرخه مهندسی (Pipeline) متوالی دارد که موفقیت آن به دقت اجرای هر مرحله بستگی دارد. برای اینکه بتوانید Fine-tune مدل زبانی یا هر مدل هوش مصنوعی دیگری را با موفقیت انجام دهید، باید این ۶ گام اساسی را طی کنید:
گام اول- انتخاب و آمادهسازی مدل پایه
هیچکس چرخ را از اول اختراع نمیکند؛ بنابراین اولین قدم، انتخاب یک مدل پیشآموزشدیده عمومی است که معماری و حجم آن با هدف شما سازگار باشد (مثلاً مدلهای خانواده Llama یا Mistral برای کارهای متنی متداول یا BERT برای پردازش زبان طبیعی خاص). حجم مدل (تعداد پارامترها) را باید براساس توان پردازشی زیرساخت خود انتخاب کنید.
گام دوم- جمعآوری و مهندسی دادهها
پاشنه آشیل تنظیم دقیق مدل هوش مصنوعی، دیتایی است که به خورد آن میدهید. در این مرحله باید دادههای مرتبط با حوزه تخصصی خود را جمعآوری کنید. بهخاطر داشته باشید که در این فرایند، «کیفیت بر کمیت پیروز است»؛ دیتای کثیف، متناقض یا تکراری خروجی مدل را خراب میکند.
گام سوم- پیشپردازش و قالببندی
دادههای خام برای مدل قابلفهم نیستند. در این بخش دیتای تخصصی شما باید دستخوش تغییرات زیر شود:
- پاکسازی: حذف نویزها، غلطهای املایی و بخشهای زائد متن
- قالببندی (Formatting): تبدیل دادهها به فرمتهای استاندارد (مانند جفتهای پرسش و پاسخ در مدلهای محاورهای)
- توکنایز (Tokenization): تبدیل متن به کدهای عددی قابل درک برای شبکه عصبی مدل
گام چهارم- فرایند آموزش با نرخ یادگیری پایین (Training Loop)
در اینجا است که دیتای تخصصی به مدل تزریق میشود. نکته طلایی در این بخش از مراحل فاین تیونینگ مدل این است که فرایند آموزش باید حتماً با نرخ یادگیری بسیار پایین (Low Learning Rate) انجام شود تا لایههای عمیق مدل آسیب نبینند.
گام پنجم- ارزیابی عملکرد و سنجش خروجی (Evaluation)
پساز پایان فرایند آموزش، باید مدل را با یک مجموعه داده تست (Validation Set) که مدل قبلاً در طول آموزش آن را ندیده است ارزیابی کنید. در این مرحله با استفاده از معیارهای فنی (مانند Loss یا معیارهای ارزیابی انسانی) بررسی میشود که آیا مدل واقعاً متخصص شده یا فقط دادهها را حفظ کرده است.
گام ششم- بهینهسازی متقاطع و تکرار (Iteration)
بهندرت پیش میآید که در تلاش اول به بهترین نتیجه برسید. براساس نتایج ارزیابی گام پنجم، شما باید هایپرپارامترها را تغییر دهید، کیفیت دادهها را اصلاح کنید یا درصورت نیاز از روشهای اقتصادیتر استفاده کنید تا مدل به پایداری کامل برسد.
انواع فاین تیونینگ چیست؟ (انتخاب بهترین استراتژی)
فاین تیونینگ مدلهای زبانی برای همه پروژهها یکسان نیست. بسته به حجم مدل پایه، بودجه و منابع پردازشی (GPU) که در اختیار دارید، باید رویکرد متفاوتی را انتخاب کنید. بهطورکلی، روشهای تنظیم دقیق مدل هوش مصنوعی به چهار دسته اصلی تقسیم میشوند که هر کدام سناریوی استفاده خود را دارند:
۱. فاین تیونینگ کامل (Full Fine-tuning)
در این روش هیچ استثنایی وجود ندارد؛ تمام پارامترها و وزنهای مدل پایه در طول فرایند آموزش مجدداً بهروزرسانی میشوند.
- مزیت: بالاترین میزان انطباق و انعطافپذیری مدل با دیتای تخصصی جدید
- چالش: نیاز به حافظه و سختافزار فوقالعاده سنگین؛ همچنین ریسک ابتلای مدل به «فراموشی فاجعهبار» -که قبلا هشدار دادیم- در این روش بسیار بالا است.
۲. فاین تیونینگ جزئی (Partial Fine-tuning)
یک راهکار میانی میان روش کامل و اقتصادی است. در این متد، لایههای اولیه شبکه عصبی مدل (که وظیفه درک ساختار عمومی زبان یا تصویر را دارند) اصطلاحاً منجمد (Freeze) میشوند و فرایند آموزش فقط روی چند لایه انتهایی یا لایههای خروجی متمرکز میشود.
- کاربرد: زمانی که مدل پایه منطق کلی را خوب میشناسد و فقط نیاز دارید خروجی نهایی آن را به لحن یا فرمت خاصی محدود کنید.
۳. فاین تیونینگ کارآمد پارامتری (PEFT)
پاسخ خلاقانه مهندسان به هزینههای سرسامآور زیرساخت، روش PEFT (Parameter-Efficient Fine-Tuning) است. در این رویکرد، وزنهای اصلی مدل به هیچوجه تغییر نمیکنند، بلکه درصد بسیار کوچکی از پارامترهای کمکی (معمولاً کمتر از ۵ درصد) به مدل اضافه شده و فقط همانها آموزش میبینند. در حوزه آموزش فاین تیونینگ مدلهای هوش مصنوعی، دو تکنیک انقلابی زیر پرچم PEFT تعریف میشوند:
۱- LoRA (Low-Rank Adaptation):
وزنهای اصلی را دستنخورده باقی میگذارد و تغییرات را در قالب دو ماتریس کوچک و کمحجم به لایههای مدل تزریق میکند. سرعت بالا و نیاز به حافظه کم، آن را به محبوبترین روش تبدیل کرده است.
۲- QLoRA (Quantized LoRA):
نسخه ارتقایافته و فشردهشده LoRA است. در QLoRA مدل پایه ابتدا به فرمت ۴ بیتی تبدیل (کوانتایز) میشود تا فضای بسیار کمتری از کارت گرافیک را اشغال کند. با این روش، حتی مدلهای بزرگ را میتوان روی زیرساختهای محدودتر بهراحتی تنظیم دقیق کرد.
۴. روشهای مبتنی بر آداپتر (Adapter-based)
در این ساختار، لایههای فشرده و کوچکی به نام «آداپتر» در میان لایههای اصلی معماری مدل پایه قرار میگیرند. مدل اصلی کاملاً فریز میماند و این لایههای الحاقی هستند که یاد میگیرند چگونه دادههای جدید را پردازش و رمزگشایی کنند.
جدول مقایسه انواع روشهای فاین تیونینگ
برای اینکه دید بهتری نسبت به انتخاب نقشه راه پروژه خود داشته باشید، ویژگیهای این ۴ روش را در جدول زیر خلاصه کردهایم:
| نوع روش | وضعیت پارامترهای اصلی | میزان مصرف منابع (GPU) | ریسک فراموشی مدل |
|---|---|---|---|
| Full Fine-tuning | همه تغییر میکنند | بسیار شدید | بسیار بالا |
| Partial Fine-tuning | بخشی فریز، بخشی تغییر میکند | متوسط | متوسط |
| PEFT (LoRA / QLoRA) | کاملاً فریز (پارامتر کمکی اضافه میشود) | بسیار کم و بهینه | نزدیک به صفر |
| Adapter-based | کاملاً فریز (لایه الحاقی اضافه میشود) | کم | بسیار پایین |
کاربرد Fine-tuning در هوش مصنوعی
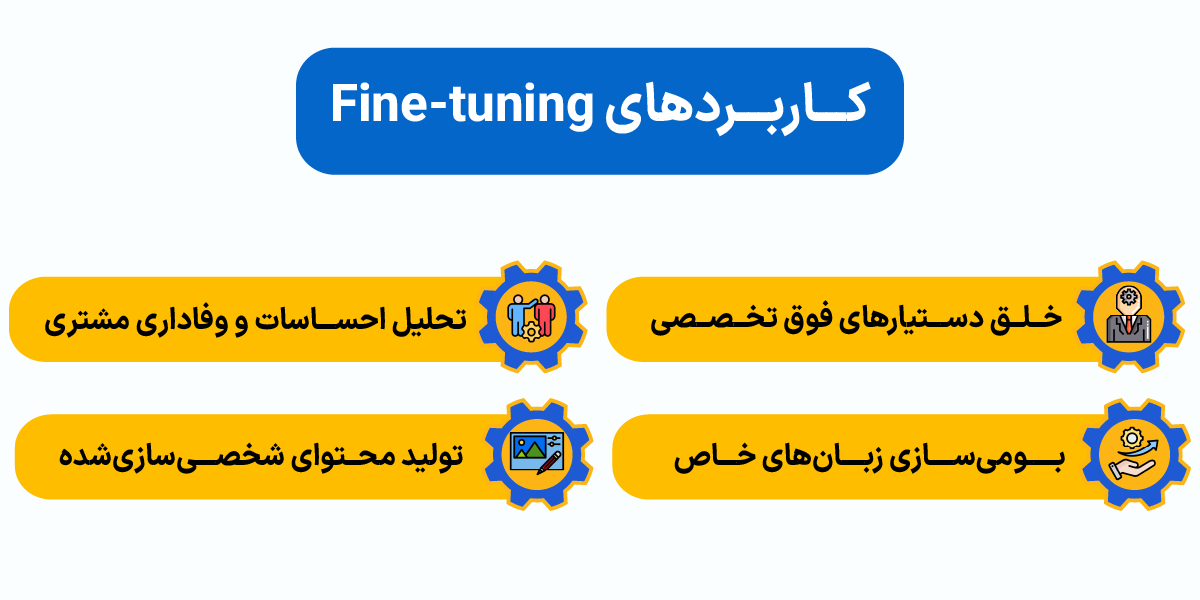
مدلهای عمومی هوش مصنوعی مثل لایسنسهای همهکاره یا آچارهای فرانسوی هستند که در کلیات به کار میآیند، اما وقتی پای مثلاً یک تحلیل حقوقی پیچیده در میان باشد ابزار تخصصی خود را میطلبند. Fine-tune مدل زبانی همانطورکه گفتیم کارش دقیقاً همین است. اما وقتی سناریوهای واقعی کسبوکارها را بررسی میکنیم، تنظیم دقیق مدل خودش را در حوزههای زیر بهعنوان یک ضرورت نشان میدهد:
- خلق دستیارهای فوق تخصصی (پزشکی، حقوقی، مالی):
یک مدل عمومی شاید فرق دو اصطلاح حقوقی یا مالی را بداند، اما توانایی تنظیم یک قرارداد تجاریِ بدون نقص یا تحلیل ترازنامههای مالی با فرمت بومی را ندارد. فاینتیونینگ این شکاف را پر میکند.
- درک عمیق و بومیسازی زبانهای خاص:
یکی از جذابترین جنبههای این فناوری، فاین تیونینگ مدلهای زبان فارسی است. مدلهای جهانی معمولاً با ساختارهای پیچیده، کنایهها و فرهنگ زبانی ما غریبهاند. با تنظیم دقیق، خروجی مدل کاملاً طبیعی، روان و متناسب با ادبیات فارسی میشود.
- تحلیل احساسات و وفاداری مشتری (Sentiment Analysis):
کسبوکارهای بزرگ با Fine-tune مدل زبانی خود روی کامنتها، تیکتها و بازخوردهای مشتریان، سیستمی میسازند که میتواند لحن شاکی، راضی یا کنایهآمیز مخاطب را با دقت بالایی تشخیص دهد و استراتژی پاسخگویی را تعیین کند.
- تولید محتوا و شخصیسازی لحن برند:
اگر میخواهید هوش مصنوعی دقیقاً با هویت بصری، لحن (Tone of Voice) و چارچوبهای برند شما محتوا تولید کند، راهکار آن پرامپت نویسی طولانی نیست؛ بلکه باید بهسراغ فاین تیونینگ بروید.
شاید بپرسید در ابعاد بزرگتر، اصلاً هدف از فاین تیونینگ LLM چیست؟ پاسخ ساده است: شخصیسازی خروجی در مقیاس بالا (Scale)؛ جوری که مدل بدون نیاز به راهنماییهای مداوم، در ۹۹ درصد مواقع دقیقاً همان خروجی مدنظر سیستم شما را تولید کند.
مزایا و معایب Fine-tuning
تنظیم دقیق مدل یک فرآیند مهندسی است که در کنار تمام خروجیهای شگفتانگیزی که دارد، محدودیتها و چالشهای خاص خود را هم به پروژه تحمیل میکند. برای اینکه در تصمیمگیریهای استراتژیک دچار اشتباه نشوید، باید مزایا و محدودیتهای این روش را بهدقت بسنجید.
مزایای اصلی فاین تیونینگ چیست؟
- کارایی بالا با دادههای محدود: برعکس مرحله پیشآموزش که به ترابایتها داده نیاز دارد، این فرایند حتی با حجم کوچکی از دادههای آموزشی تخصصی نیز عملکرد فوقالعادهای از خود نشان میدهد.
- بهبود چشمگیر در تسکهای تخصصی: عملکرد مدل در حوزههای حساسی مثل پزشکی، مباحث حقوقی و کاربردهای مالی که نیاز به درک جزییات دارند، بهشکل قابلتوجهی ارتقا مییابد.
- صرفهجویی شدید در زمان: بهجای هدر دادن زمان و هزینههای نجومی برای آموزش یک مدل از صفر (From Scratch)، یک مدل قدرتمندِ موجود را متناسب با نیاز خود سازگار میکنید.
- دقت بالا به لطف دانش قبلی: مدل نیازی به یادگیری دوباره ساختار زبان یا منطق جهان ندارد؛ بلکه از حجم عظیم دانشی که در مرحله پیشآموزش یاد گرفته، برای حل چالشهای جدید استفاده میکند.
- کاهش ریسک بیشبرازش (Overfitting) روی دیتای کوچک: ازآنجاکه پایه مدل روی میلیاردها داده عمومی تثبیت شده، بازآموزی آن روی دادههای اختصاصیِ کوچکتر، کمتر از آموزش یک مدل خام از صفر، ریسک خطای اورفیتینگ را به همراه دارد.
- نیاز به منابع پردازشی کمتر: در مقایسه با آموزش کامل و اولیه یک مدل بزرگ، فرایند تنظیم دقیق سختافزار و زیرساخت بسیار سبکتری میطلبد.
محدودیتها و چالشهایی که باید بدانید
- ریسک اورفیتینگ درصورت کمبود تنوع دیتای جدید: اگر مجموعه داده تخصصی شما بیشازحد کوچک باشد یا تنوع کافی نداشته باشد، مدل ممکن است خروجیها را حفظ کند و توانایی تعمیمدهی خود را از دست بدهد.
- نیاز به منابع پردازشی در مدلهای بسیار بزرگ: اگرچه این روش از آموزش اولیه سبکتر است، اما برای مدلهای غولپیکر همچنان به سختافزارهای قدرتمند و کارتهای گرافیک سازمانی نیاز خواهید داشت.
- چالش انتخاب لایههای مناسب: تشخیص اینکه دقیقاً کدام لایهها از شبکه عصبی باید منجمد (Freeze) شوند و کدام لایهها دستخوش تغییر وزن و تنظیم دقیق قرار بگیرند، نیاز به تخصص و تستهای مداوم دارد.
- وابستگی شدید به کیفیت مدل پایه: کیفیت خروجی نهایی شما مستقیماً به قدرت، پیشفرضها و پایداری همان مدل اولیه پردازشی که انتخاب کردهاید بستگی دارد.
- عدم کارایی درصورت تغییر ماهیت کامل تسک: اگر وظیفه جدید شما فرسنگها با هدف و دادههای اولیه مدل پیشآموزشدیده فاصله داشته باشد، فرایند فاینتیونینگ نتیجه مطلوبی نخواهد داد.
تفاوت با Prompt Engineering
یکی از رایجترین ابهاماتی که برای توسعهدهندگان و مدیران محصول پیش میآید، این است که تفاوت Fine-tuning با Prompt Engineering چیست؟ و برای حل یک مسئله مشخص، باید بهسراغ کدام راهکار بروند. پاسخ به درک یک مرز فنی ساده یعنی «دستکاری مغز مدل دربرابر دستکاری نحوه سؤال پرسیدن از آن» بستگی دارد.
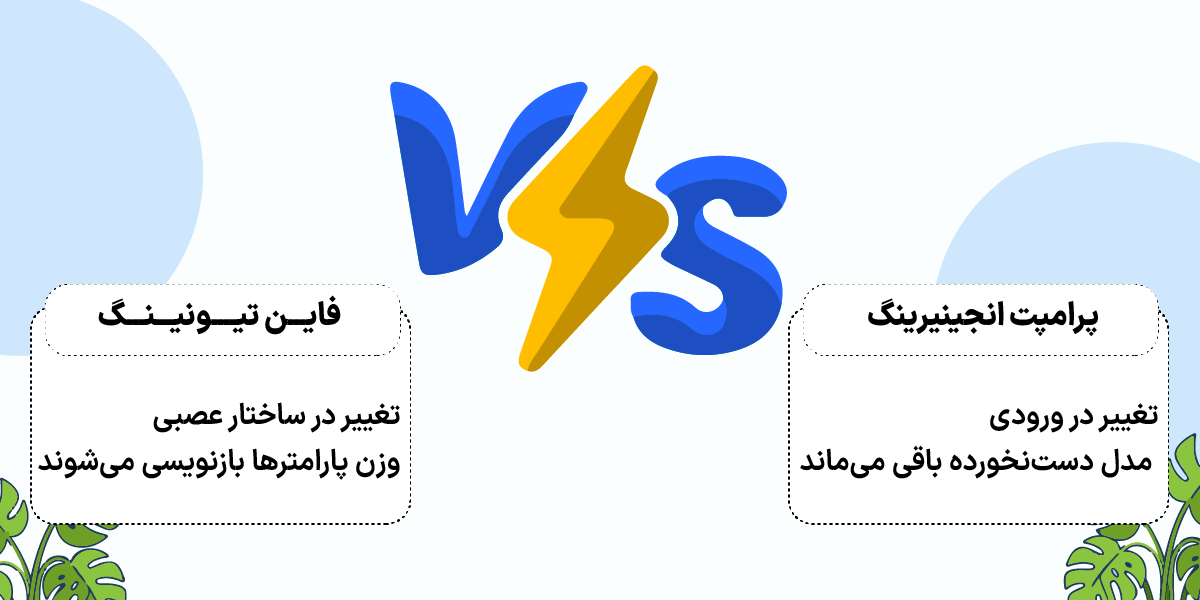
برای درک بهتر، این دو رویکرد را بررسی میکنیم:
- پرامپت انجینیرینگ (Prompt Engineering): در این روش، ساختار داخلی و وزنهای مدل هوش مصنوعی بههیچعنوان تغییر نمیکنند. شما صرفاً با طراحی هوشمندانه ورودی، دادن مثالهای درونمتنی و تعیین دقیق چارچوبها در خط فرمان، تلاش میکنید مدل عمومی را بهسمت پاسخ درست هدایت کنید.
- فاین تیونینگ (Fine-tuning): گفتیم که یک جراحی عمیق و پایدار است. در اینجا شما مستقیماً معماری و وزن پارامترهای مدل را تغییر میدهید. مدل دادههای جدید را میبلعد و آنها را به بخشی از هویت و حافظه دائمی خود تبدیل میکند.
به زبان ساده، پرامپت انجینیرینگ شبیه به این است که به یک نویسنده همهفنحریف (مثل من!)، یک کتابچه راهنمای چند صفحهای بدهید و بگویید: «براساس این دستورالعمل برای من بنویس»؛ اما تنظیم دقیق مدل هوش مصنوعی یعنی آن نویسنده را به مدت چند هفته به کلاسهای فشرده بفرستید تا دانش جدید در ذهن او نهادینه شود.
مقایسه ساختاری فاین تیونینگ و مهندسی پرامپت
| شاخص مقایسه | فاین تیونینگ | پرامپت انجینیرینگ |
|---|---|---|
| تغییر در ساختار مدل | بله؛ وزن پارامترها کاملاً تغییر میکند | خیر؛ مدل کاملاً دستنخورده میماند |
| هزینه اولیه راهاندازی | بالاتر (نیازمند جمعآوری دیتابیس و پردازش) | بسیار پایین و اقتصادی |
| سرعت رسیدن به نتیجه | نیازمند زمان برای آموزش و ارزیابی مدل | آنی و در لحظه (با تغییر متن پرامپت) |
| ماندگاری دانش | دائمی و تثبیتشده در خودِ مدل | موقتی و محدود به همان پنجره گفتگو |
| طول پرامپت و مصرف توکن | بسیار کوتاه و بهینه | طولانی (بهدلیل نیاز به تزریق جزییات و مثالها) |
چالش فاین تیونینگ مدلهای زبان فارسی
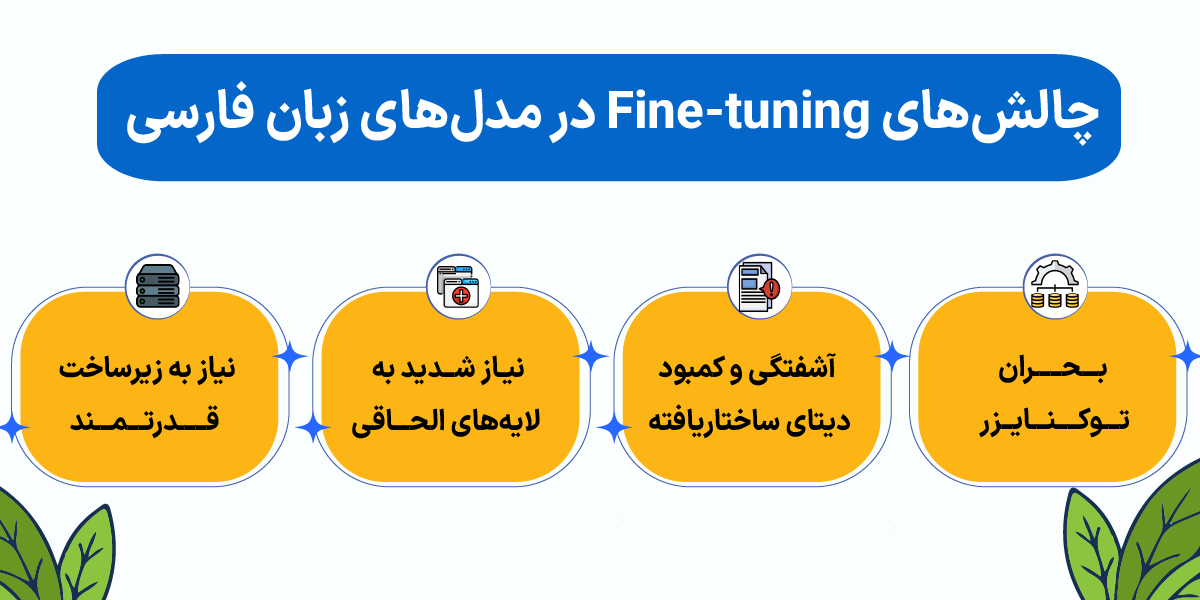
وقتی میخواهید یک مدل زبانی بزرگ جهانی (LLM) را برای درک درست ادبیات، فرهنگ و نیازهای بومی آماده کنید، متوجه میشوید که فرایند فاین تیونینگ مدلهای زبان فارسی با چالشهای فنی منحصربهفردی روبهرو است. این چالشها فراتر از یک ترجمه ساده هستند و مستقیماً با معماری و لایههای عمیق مدل درگیر میشوند:
۱- بحران توکنایزر (Tokenizer Crisis):
اکثر مدلهای متنباز دنیا (مانند لاما یا میسترال) بر پایه زبان انگلیسی توکنایز شدهاند. در نتیجه، یک کلمه فارسی که باید یک توکن حساب شود، گاهی به ۳ یا ۴ بخش (توکن) شکسته میشود. این یعنی مدل برای خواندن و نوشتن متن فارسی، رم گرافیکی (VRAM) بسیار بیشتری مصرف میکند و سرعت پاسخگویی آن بهشدت افت میکند. برای حل این مشکل، توسعهدهندگان باید واژهنامه (Vocabulary) مدل را پیشاز شروع فرایند با دیتای فارسی غنی سازند.
۲- آشفتگی و کمبود دیتای ساختاریافته:
هوش مصنوعی زبان فارسی را از روی وب یاد میگیرد؛ فضایی که پُر از غلطهای املایی، آشفتگی در رعایت نیمفاصلهها و متون نامعتبر است. اگر دیتای اختصاصی کسبوکار شما پیشاز شروع آموزش به کمک ابزارهای پردازش زبان طبیعی (NLP) پاکسازی و قالببندی (مثلاً به سبکInstruction یا جفتهای پرسش و پاسخ) نشود، مدل بعداز فاینتیونینگ دچار هذیانگویی (Hallucination) یا تکرار مکررات میشود.
۳- نیاز شدید به لایههای الحاقی (LoRA):
بهدلیل محدودیت منابع و حجم بالای پارامترها، در پروژههای فارسی معمولاً به سراغ فاینتیونینگ کامل نمیروند. مهندسان تلاش میکنند با تزریق ماژولهای کمکی کوچک (LoRA adapters) اختصاصی برای زبان فارسی، بدون دستکاری مغز اصلی مدل، رفتار زبانی آن را بومیسازی کنند که این کار به دقت بالایی در تنظیم نرخ یادگیری نیاز دارد.
4- نیاز به زیرساخت قدرتمند
علاوهبر موارد بالا، تمام این مراحل پردازشی عمیق و ریاضی، نیازمند یک بازوی سختافزاری قدرتمند است تا فرایند تغییر وزن پارامترها بدون کرش کردن دیسک یا خطای کمبود حافظه (OOM) جلو برود.
اگر به دنبال بستری حرفهای برای توسعه هستید، پیشنهاد ابر فردوسی به شما سرور هوش مصنوعی است. سرور AI ابر فردوسی، بستری ایزوله، ایمن و پرچمدار را برای مهندسان هوش مصنوعی کشور فراهم کرده است که تمامی نیازهای سختافزاری آنها را برآورده میکند. مزایای این سرورها را در جدول زیر بخوانید.
اگر میخواهید بدانید پلتفرمهای پردازش ابری هوش مصنوعی دقیقاً چطور این بار سنگین را جابهجا میکنند، پیشنهاد میکنیم ابتدا مقاله توضیحی ما در لینک زیر را مطالعه کنید.
مزایای عملیاتی سرور هوش مصنوعی ابر فردوسی
| ویژگی | مزیت عملیاتی برای پروژه هوش مصنوعی شما |
|---|---|
| امکان خاموشی فوری سرور | در ساعاتی که پردازش ندارید سرور را خاموش کنید؛ دیتای شما کاملاً حفظ میشود و هزینهای بابت منابع پردازشی کسر نخواهد شد. |
| پرداخت ساعتی | بدون نیاز به خریدهای سالانه نجومی، هزینهها را براساس مصرف واقعی خود و با امکان خاموشی سرور با حفظ دادهها مدیریت کنید. |
| تحویل و سفارش آنی | بدون هدر رفتن وقت و دخالت انسانی، سرور ابری شما در لحظه سفارش آماده کار و کدنویسی است. |
| منابع اختصاصی | کارتهای گرافیک و سختافزارها بهصورت کاملاً اختصاصی (Dedicated) در اختیار شماست و با هیچ کاربر دیگری بهاشتراک گذاشته نمیشود. |
| امنیت با اسنپشات لحظهای | سیستم بکآپگیری و اسنپشات لحظهای ابر فردوسی، امنیت و پایداری کدهای شما را در طول فاز آموزش تضمین میکند. |
| حمایت از گرنتهای علمی | پشتیبانی کامل از گرنتهای لبزنت (تا ۱۰۰٪)، ستاد توسعه هوش مصنوعی (تا ۲۰۰ میلیون تومان)، اساتید، دانشجویان و صنایع |
تغییر متدولوژی و ورود به پردازشهای سنگین همواره با چالشهای مالی همراه است؛ به همین دلیل، ابر فردوسی امکان تست دمو را فراهم کرده است. شما بهمحض ثبتنام، ۱۰۰ هزار تومان اعتبار هدیه دریافت میکنید تا بتوانید بدون ثانیهای ریسک مالی، کیفیت زیرساخت، سرعت دیسکهای NVMe و سازگاری ابزارهای یادگیری عمیق را کاملاً رایگان ارزیابی کنید و سپس تصمیم بگیرید.
جمعبندی
در این مقاله از الف تا ی مفاهیم را کالبدشکافی کردیم؛ یاد گرفتیم که فاین تیونینگ چیست، چگونه یک مدل هوش مصنوعی را Fine-tune کنیم و چطور تکنیکهای هوشمندانهای مثل PEFT (بهویژه LoRA و QLoRA) هزینههای راهاندازی را به حداقل میرسانند. همچنین دیدیم که چرا مهندسی پرامپت یک راهکار موقت است، اما تنظیم دقیق مدل، ساختار و مغز هوش مصنوعی را بازنویسی میکند. در نهایت مشخص است که زیرساخت پردازشی و دسترسی به پردازندههای گرافیکی قدرتمند، شریان حیاتی این فرآیند است.
شما هم تجربه شخصیسازی یک مدل زبانی بزرگ را داشتهاید؟ در پروژههای خود با چه چالشهایی در زمینه سختافزار یا جمعآوری دادههای فارسی روبهرو شدهاید؟ نظرات، تجربیات و سؤالات فنی خود را در بخش کامنتها بنویسید.
منابع:
Ibm | geeksforgeeks | coursera
سؤالات متداول
Fine-tuning چیست و چه فرقی با آموزش اولیه (Pre-training) دارد؟
در مرحله آموزش اولیه، مدل روی حجم عظیمی از دادههای عمومی وب (ترابایتها متن) باز میشود تا ساختار زبان و قواعد کلی جهان را یاد بگیرد. اما فاین تیونینگ یعنی بازآموزیِ همان مدلِ همهچیزدان روی یک مجموعه داده اختصاصی، محدود و کاملاً تمیز، تا رفتار و دانش آن برای یک تسک مشخص (مانند تحلیلهای مالی یا پزشکی) بهینهسازی شود.
فاین تیونینگ مدلهای زبانی چگونه انجام میشود؟
ابتدا یک مدل پایه متنباز انتخاب میشود، سپس دادههای تخصصی جمعآوری، پاکسازی و توکنایز میشوند. در گام بعدی مدل با یک نرخ یادگیری بسیار پایین تحت آموزش قرار میگیرد و در نهایت خروجی آن با دادههای تست (Validation Set) ارزیابی و صیقل داده میشود.
تفاوت Fine-tuning با Prompt Engineering و RAG چیست؟
پرامپت انجینیرینگ: دستکاری نحوه سؤال پرسیدن از مدل بدون تغییر در ساختار آن است (سریع، موقت و محدود به طول حافظه گفتگو)
RAG (بازیابی مستندات): متصل کردن مدل به یک پایگاه داده خارجی برای خواندن اطلاعات بهروز، بدون تغییر در وزن پارامترها
فاین تیونینگ: یک جراحی عمیق روی معماری هوش مصنوعی است؛ دادههای جدید به مغز مدل تزریق و وزن پارامترها تغییر مییابند (دائمی، ساختاری و عمیق)
برای تنظیم دقیق مدل به چه مقدار داده نیاز داریم؟ آیا خطر Overfitting وجود دارد؟
برعکس آموزش اولیه، در این فرایند حتی با چندصد تا چندهزار نمونه داده باکیفیت هم میتوانید به نتیجه برسید. بااینحال، اگر تنوع دادههای تخصصی شما خیلی کم باشد یا مدل را روی یک دیتای محدود بچرخانید، مدل دچار بیشبرازش (Overfitting) میشود؛ یعنی دادهها را حفظ میکند و کارایی عمومیاش را از دست میدهد.
برای فاینتیونینگ باید کدام لایههای مدل را فریز کنیم و نرخ یادگیری چقدر باشد؟
در روشهای پیشرفته ولی اقتصادی مانند PEFT و LoRA، تمام لایههای اصلی مدل پایه فریز (Freeze) میشوند و تغییرات فقط روی لایههای الحاقی بسیار کوچک اعمال میشود. نرخ یادگیری در این فاز باید بسیار پایین (معمولاً بین ۰.۰۰۰۰۱ تا ۰.۰۰۰۱) انتخاب شود؛ در غیر این صورت، مدل دچار فراموشی فاجعهبار میشود و دانش عمومی قبلی خود را کاملاً پاک میکند.
هزینه فاین تیونینگ چقدر است و به چه سختافزاری نیاز دارد؟
هزینه فاین تیونینگ ارتباط مستقیمی با تعداد پارامترهای مدل پایه و حجم توکنهای دیتابیس شما دارد. بخش اصلی هزینهها مربوط به زیرساخت پردازشی (GPU) است؛ زیرا مدلهای بزرگ برای تغییر وزن پارامترها به کارتهای گرافیک سازمانی با حافظه و پهنای باند بالا (مانند سری Tesla یا H Series) نیاز دارند. استفاده از متدهای فشردهسازی مثل QLoRA میتوان این هزینههای سختافزاری را بهحداقل رساند.