خیلی از توسعهدهندگان و مهندسان داده وقتی با حجم سنگینی از اطلاعات مواجه میشوند، اولین فکرشان اجرای پردازشها بهمحض ورود هر داده است. اما پردازش لحظهایِ تکتک رکوردها، زیر بارهای ترافیکی سنگین منابع سرور را بیدلیل اشباع میکند؛ آنهم در شرایطی که بسیاری از گزارشها و تحلیلها اصلاً نیازی به پاسخدهی آنی ندارند. برای حل این محدودیت، مفهومی به نام پردازش دستهای (Batch Processing) معرفی شده است.
پردازش دستهای یا پردازش گروهی دادهها روشی است که در آن، حجم عظیمی از اطلاعات در طول یک بازه زمانی مشخص جمعآوری شده و سپس بهصورت یکجا (در قالب یک بسته یا Batch)، بدون نیاز به دخالت کاربر و معمولاً در ساعات خلوتی سیستم اجرا میشوند. در این مقاله بررسی خواهیم کرد که سیستم پردازش دستهای چیست و چگونه کار میکند، چه تفاوتی با پردازش لحظهای (Real-time) دارد و در سناریوهای کلانداده، اسکریپتهای پایتون و مدیریت زیرساخت سرورها چه کاربردهای عملی و مفیدی ارائه میدهد.
جدول محتواها
پردازش دستهای چگونه کار میکند؟
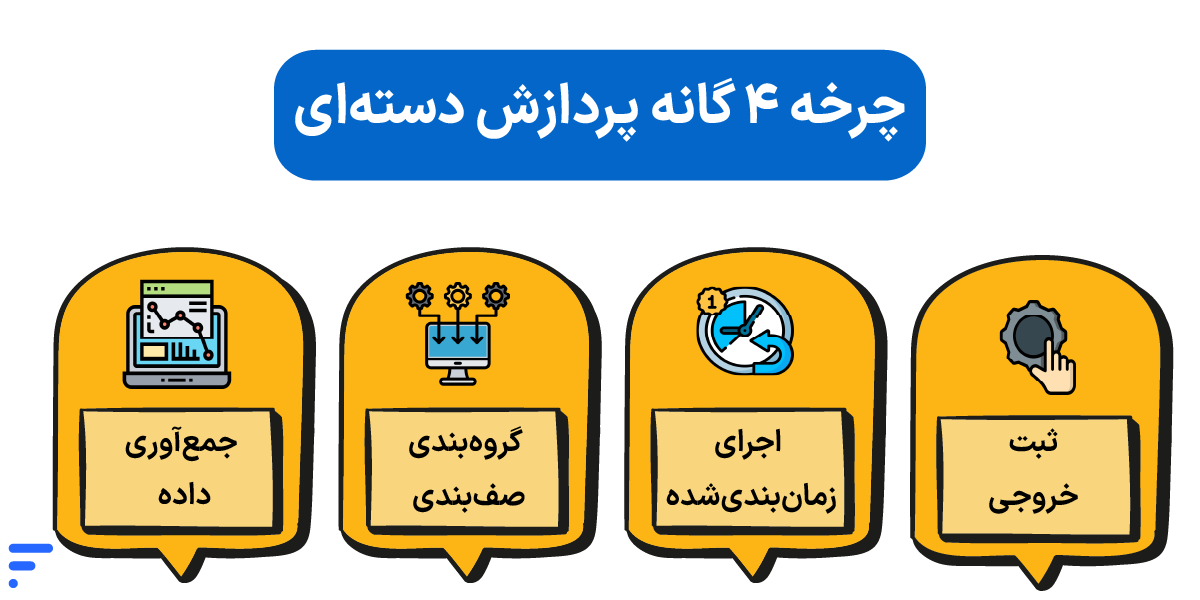
طراحی سیستم پردازش دستهای بر پایه یک منطق ساده استوار است: بهجای اینکه سیستم برای هر دادهی ورودی دستبهکار شود، منتظر میماند تا حجم مشخصی از اطلاعات جمعآوری شوند یا زمان معینی فرا برسد. نحوه کارکرد این فرایند را میتوان در ۴ گام اصلی خلاصه کرد:
- جمعآوری دادهها (Data Collection): دادههای خامی که از منابع مختلف (مثل فایلهای لاگ، تراکنشهای متنی یا دیتابیسها) میآیند، در طول زمان استخراج میشوند و در یک محیط ذخیرهسازی موقت قرار میگیرند.
- گروهبندی و صفبندی (Batching & Queuing): دادههای جمعآوریشده براساس حجم، فرمت یا اولویت به دستههای کوچکتری تقسیم شده و درون صفِ اجرای پردازش چیده میشوند.
- اجرای پردازش (Execution): در زمان تعیینشده، موتور پردازشی روشن میشود و پردازش دستهای دادهها را بهصورت یکجا و بدون نیاز به دخالت انسانی اجرا میکند.
- ذخیره یا ارسال خروجی (Output Generation): نتایج تحلیل یا تغییرات نهایی در دیتابیس اصلی، انباره داده (Data Warehouse) یا فایلهای خروجی ثبت و منابع سرور آزاد میشوند.
نقش سیستمهای زمانبندی (Job Schedulers)
بدون ابزارهای زمانبندی، پردازش آفلاین داده باید بهصورت دستی اجرا شود که ریسک خطای انسانی را بالا میبرد. سیستمهای زمانبندی وظیفه دارند اجرا شدن فرایندها را خودکار کنند:
- ابزارهای پایه: در سیستمعاملهای لینوکسی، ابزارهایی مانند Cron Job دستورات و اسکریپتها را در ساعات مشخصی از شبانهروز (مثلاً ۲ بامداد) اجرا میکنند.
- ابزارهای پیشرفته: در پروژههای بزرگتر و معماریهای پیچیده، ابزارهایی مثل Apache Airflow، Celery یا Slurm مدیریت اجرا، مانیتورینگ و ارسال اعلان خطاهای احتمالی را برعهده میگیرند.
مدیریت وابستگیهای بین Jobها
در خیلی از سناریوها، یک پردازش نمیتواند قبلاز تکمیل پردازش دیگر شروع شود. برای مثال، ابتدا باید دادهها پاکسازی و استاندارد شوند (Job1)، سپس محاسبات آماری روی آنها انجام گیرد (Job2) و در نهایت گزارش PDF ساخته شود (Job3). سیستمهای مدرن پردازش دستهای، این وابستگیها را به شکل یک گراف جهتدار بدون دور (DAG) مدیریت میکنند تا اگر گام اول با خطا مواجه شد، گامهای بعدی بیدلیل اجرا نشوند و منابع سرور را هدر ندهند.
اندازه دسته (Batch Size) و تأثیر آن بر کارایی
یکی از مهمترین فاکتورها در تنظیمات پردازش گروهی، تعیین درست اندازه دسته یا همان Batch Size است.
- اندازه دسته خیلی کوچک: باعث افزایش Over head سرور و رفتوبرگشتهای متوالی به دیسک یا شبکه میشود.
- اندازه دسته خیلی بزرگ: حافظه رم (RAM) سرور را پر میکند و ممکن است باعث کرش کردن پردازش یا فعال شدن OOM Killer سیستمعامل شود.
تفاوت پردازش دستهای و پردازش لحظهای چیست؟
پساز Batch Processing چیست، یکی دیگر از سؤالاتی همواره مطرح میشود، این است که پردازش دستهای چه فرقی با پردازش لحظهای (Real-time Processing) دارد؟ باید گفت تفاوت اصلی این دو متدولوژی در زمان پاسخدهی (Latency)، شیوه مصرف منابع و نیاز پروژه است.
در پردازش لحظهای، هر داده بهمحض تولید (حتی در حد یک میلیثانیه) پردازش میشود؛ مثل سیستمهای شناسایی تقلب در کارتهای اعتباری یا ردیابی زنده موقعیت مکاننما. اما در پردازش دستهای، فاکتور زمان قربانیِ کارایی و حجم بالا میشود تا دادهها بهصورت انبوه و با هزینه زیرساختی بسیار کمتری تحلیل شوند.
جدول زیر دید جامعی از تفاوتهای این دو معماری به شما میدهد:
| معیار ارزیابی | پردازش دستهای | پردازش لحظهای |
|---|---|---|
| زمان اجرا و تأخیر | تأخیر بالا (چند دقیقه، ساعتی یا روزانه) | بسیار پایین (میلیثانیه تا چند ثانیه) |
| حجم داده در هر اجرا | دادههای حجیم و تجمیعشده (High Volume) | دادههای تکی یا بستههای بسیار کوچک (Event-driven) |
| شیوه شروع پردازش | طبق زمانبندی یا رسیدن به حجم مشخص | بلافاصله پساز وقوع یک رویداد (Trigger) |
| الگوی مصرف منابع سرور | فشار متمرکز، سنگین اما کوتاهمدت به CPU/RAM | مصرف مداوم، یکنواخت و همیشگی از منابع |
| هزینه زیرساخت و پیچیدگی | پیچیدگی کمتر و هزینه نگهداری بسیار بهینهتر | پیچیدگی بالا و نیاز به سرورهای همیشه روشن و پایدار |
| سناریوهای کاربردی رایج | گزارشگیری مالی شبانه، بکاپگیری، ETL دادهها | تراکنشهای بانکی، چترومها، مانیتورینگ زنده شبکه |
مزایای پردازش دستهای
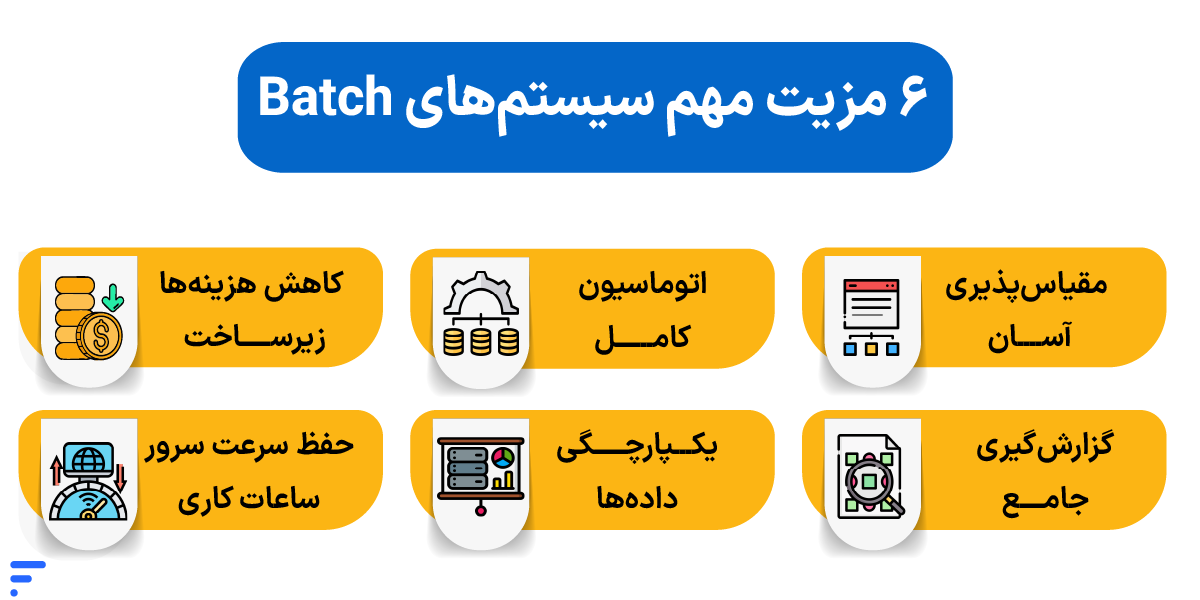
علیرغم محبوبیت پردازشهای آنی در دنیای امروز، پردازش دستهای همچنان استخوانبندی اصلی سیستمهای داده در سازمانهای بزرگ را تشکیل میدهد. دلیل این ماندگاری، مزایای سختافزاری و اقتصادی متعددی است که این روش برای زیرساختها به همراه میآورد:
- مدیریت بهینه هزینهها و منابع: با اتوماتیکسازی کارهای تکراری و اجرای آنها در ساعات خلوتی شبکه (Off-peak)، نیاز به نیروی انسانی برای نظارت مداوم از بین میرود و هزینههای عملیاتی سرور بهشدت کاهش مییابد.
- حفظ پایداری و کارایی سیستم اصلی: اگر سنگینترین محاسبات را به ساعات کمترافیک (مثلاً نیمهشب) منتقل کنید، منابع سرور در ساعات کاری در اختیار کاربران واقعی خواهد بود و سیستم با افت سرعت یا هنگ کردن مواجه نمیشود.
- اتوماسیون و کاهش خطای انسانی: استفاده از ابزارهای زمانبندی (Job Schedulers) باعث میشود پردازش گروهی دادهها طبق یک برنامه دقیق، منظم و بدون نیاز به استارت دستی اجرا شود.
- دقت بالا و یکپارچگی دادهها: در این روش تمام دادههای یک بسته تحت یک مجموعه قوانین (Ruleset) مشخص و یکسان ویرایش یا محاسبه میشوند. این یکدستی، میزان خطاهای محاسباتی را بهحداقل میرساند.
- مقیاسپذیری ساده: سیستمهای دستهای قابلیت هضم حجمهای فوقالعاده سنگین داده را دارند. اگر حجم فایلهای ورودی شما دو برابر شود، نیازی به بازنویسی معماری نیست؛ فقط کافی است منابع پردازشی اختصاصیافته به آن Batch را افزایش دهید.
- تحلیلهای کلان و گزارشگیری جامع: تجمیع دادهها در فواصل زمانی مشخص، امکان تحلیلهای عمیق مدیریتی و ساخت گزارشهای دقیق دوره ای را فراهم میکند.
محدودیتها و چالشهای Batch Processing
| چالش فنی | علت اصلی | راهکار مهندسی و عملیاتی |
|---|---|---|
| تأخیر در خروجی | ذاتِ زمانبندیشده و دستهای بودن فرایند | سوئیچ به معماری Stream/Real-time فقط برای بخشهای دارای اهمیت زمانی |
| پیچیدگی عیبیابی | کشف خطا تنها پساز اجرای کل بسته | استفاده از صف دادههای خطادار (Dead-Letter Queue) و مکانیزم Atomic Rollback |
| نوسان شدید منابع (Resource Spikes) | فشار متمرکز CPU/RAM در فواصل زمانی خاص | ایزولهسازی سرور پردازش از دیتابیس اصلی و استفاده از منابع ابری الاستیک |
| طولانی شدن زمان اجرا | رشد غیرمنتظره حجم دادههای ورودی | بهینهسازی Batch Size، موازیسازی (Parallel Processing) و ارتقای I/O دیسک |
هیچ معماری نرمافزاری کاملاً بینقص نیست و برای انتخاب درست پردازش دستهای نیز باید با محدودیتهای فنی آن آشنا باشید:
تأخیر در دسترسی به خروجی:
بزرگترین چالش پردازش آفلاین داده، فاصلهی زمانی میان تولید داده و دریافت نتیجه است. اگر به تحلیلهای آنی (مثل تراکنشهای بانکی یا چت آنلاین) نیاز دارید، این روش اصلاً مناسب پروژه شما نیست.
پیچیدگی در عیبیابی و مدیریت خطا:
در یک بسته بزرگ، اگر یک رکورد خراب وجود داشته باشد یا پردازش در وسط راه کرش کند، معمولاً کل فرایند متوقف یا باطل میشود. پیدا کردن اینکه کدام خط از میان میلیونها داده باعث بروز خطا شده زمانبر و دشوار است.
نوسان شدید در الگوی مصرف منابع (Resource Spikes):
مصرف منابع در این روش خطی نیست؛ سرور ساعتها در حالت بیکاری (Idle) قرار دارد و ناگهان در زمان اجرای Batch، مصرف CPU و RAM به ۱۰۰ درصد میرسد. مدیریت این نوسان سختافزاری نیاز به کانفیگ دقیق دارد.
چالش طولانی شدن زمان اجرا:
اگر حجم دادهها بهمرور زمان رشد کند، ممکن است زمان پردازش آنقدر طولانی شود که از ساعات خلوتی شبانه فراتر برود و به ساعات کاری صبح بکشد یا فرایندهای بکاپگیری سرور را مختل کند.
انعطافپذیری پایین در کارهای ناگهانی (Ad-hoc Tasks):
این سیستمها برای منطقهای ازپیشتعریفشده ساخته شدهاند. اگر مدیر مجموعه یک گزارش فوری و خارج از ساختار زمانبندی بخواهد، اجرای آن مستلزم دستکاری کانفیگها و صرف زمان خواهد بود.
کاربردهای پردازش دستهای چیست؟
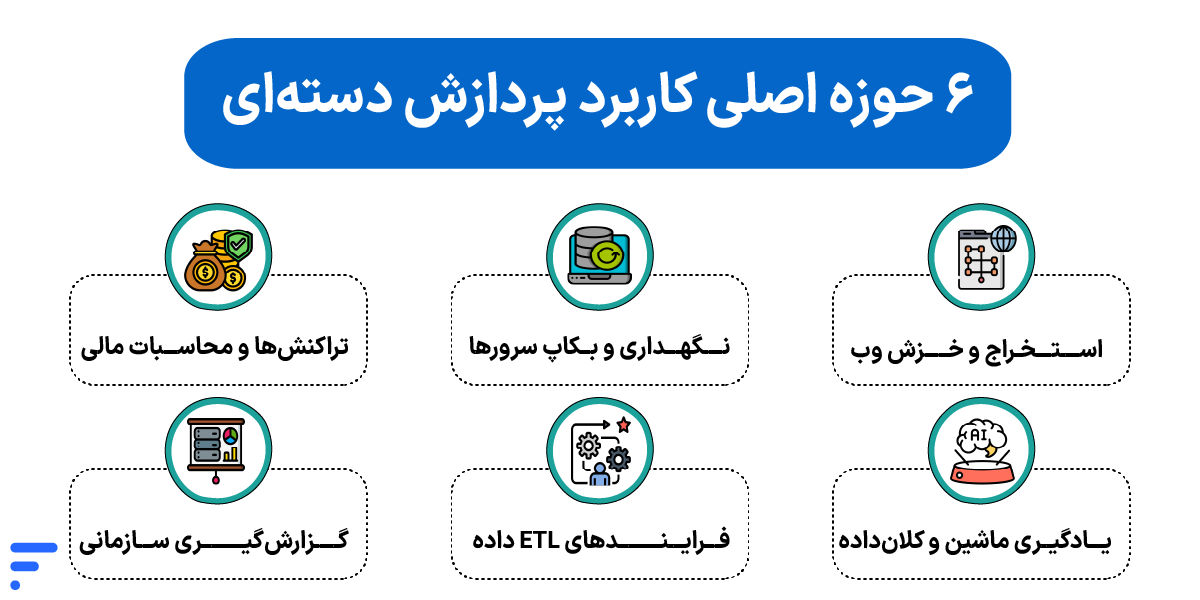
در نگاه اول شاید تصور کنید با پیدایش سیستمهای آنی، روشهای قدیمیتر کنار رفتهاند؛ اما واقعیتِ صنعت نرمافزار متفاوت است. پردازش دستهای دادهها هنوز هم قلب نبضدهنده زیرساختهای غولپیکر داده است. هرجاکه حجم عظیمی از اطلاعات نیاز به محاسبات تکراری داشته باشد و فوریت صدمثانیهای مطرح نباشد، این روش حرف اول را میزند.
در ادامه، مهمترین سناریوهای کاربردی این معماری را بررسی میکنیم:
۱. سیستمهای مالی، بانکی و حسابداری
صنعت مالی و بانکداری بدون سیستم پردازش دستهای عملاً فلج میشود. سیستمهای بانکی نمیتوانند سود روزانه میلیونها حساب یا محاسبه اقساط را در ساعات کاری و روی دیتابیس زنده انجام دهند.
- محاسبات انتهای روز: محاسبه تسویهحسابهای بینبانکی، بروزرسانی مانده حسابها و محاسبه سود در انتهای شب
- پردازش حقوق و دستمزد (Payroll): محاسبه کسورات، مالیات و واریز یکجای حقوق هزاران پرسنل یک سازمان در یک بسته زمانی مشخص
- صدور قبوض و فاکتورها: شرکتهای خدماتدهنده (مثل اپراتورهای همراه یا شرکتهای برق و آب) دادههای مصرفی طول ماه را جمعآوری میکنند و در انتهای دوره بهصورت دستهای فاکتورها را صادر میکنند.
۲. گزارشگیری و تحلیل دادههای سازمانی
مدیران ارشد برای تصمیمگیریهای استراتژیک به گزارشهای تحلیلی جامع نیاز دارند. تولید این گزارشها مستلزم کوئریهای بسیار سنگین روی دیتابیس است.
- اجرای محاسبات پیچیده ریاضی و تجمیع دادهها (Aggregations) روی دادههای فروش یا رفتار کاربران در طول شب
- تولید گزارشهای PDF یا داشبوردهای مدیریتی بدون اینکه سرعت پاسخدهی سایت یا اپلیکیشن به کاربران واقعی افت کند.
۳. فرایندهای ETL و آمادهسازی داده
در مهندسی داده، خط لوله ETL (استخراج، تغییر شکل و بارگذاری) پایهواساس ساخت انباره داده (Data Warehouse) است.
- استخراج (Extract): جمعآوری لاگها و تراکنشهای خام از دیتابیسهای عملیاتی مختلف
- تغییر شکل (Transform): استانداردسازی فرمتها، پاکسازی دادههای کثیف و حذف رکوردهای تکراری بهصورت پردازش گروهی دادهها
- بارگذاری (Load): تزریق دادههای تمیزشده به دیتابیسهای تحلیلی مانند BigQuery یا ClickHouse
۴. پردازش آفلاین داده در سرورها و نگهداری سیستم
تیمهای DevOps و ادمینهای شبکه برای پایداری زیرساخت خود بهشدت به اسکریپتهای زمانبندیشده وابسته هستند:
- بکاپگیری خودکار: فشردهسازی و رمزنگاری فایلها و دیتابیسها در ساعات خلوتی و ارسال آنها به سرور پشتیبان
- بهروزرسانیهای امنیتی: دانلود و نصب پچهای نرمافزاری و ایمیجهای سیستمعامل بهصورت دستهای
- چرخش لاگها (Log Rotation): آرشیو کردن لاگهای قدیمی سرور برای جلوگیری از پُر شدن ناگهانی فضای دیسک
۵. سناریوهای کلانداده (Big Data) و یادگیری ماشین (ML)
در صنعت هوش مصنوعی و کلانداده، پردازشهای تکتک پاسخگو نیستند:
- آمادهسازی دادههای آموزش (Pre-processing): تبدیل میلیونها تصویر یا متن خام به فرمتهای برداری (Tensor) جهت آموزش مدلهای یادگیری عمیق
- استنتاج دستهای (Batch Inference): اجرا کردن یک مدل پیشبینیکننده روی میلیونها رکورد مشتری (مثلاً برای شناسایی احتمال ریزش کاربران) در انتهای هر هفته
- شبیهسازیهای علمی: پردازش انبوه داده در پروژههای پردازش تصویر پزشکی، ژنتیک و مدلسازیهای اقلیمی
۶. استخراج دادهها و خزش وب (Web Scraping)
جمعآوری اطلاعات قیمت رقبا، اخبار یا اطلاعات بازار از سطح وب معمولاً بهصورت پردازش آفلاین داده پیادهسازی میشود. در وب اسکرپینگ، اسکریپتها هزاران صفحه وب را دانلود و محتوای آنها را پارس میکنند و نتایج ساختاریافته را در قالب بستههای تجمیعشده درون دیتابیس ذخیره میسازند.
پردازش دستهای در سرورها
وقتی از پروژههای واقعی و دیتابیسهای چند ده گیگابایتی صحبت میکنیم، اجرای پردازش آفلاین داده روی سیستمهای شخصی یا سیستمعاملهای معمولی امکانپذیر نیست. سیستم پردازش دستهای به منابع سختافزاری پایدار، پهنای باند دیسک (IOPS) بالا و قدرت پردازش موازی نیاز دارد؛ مواردی که فقط زیرساختهای سروری قادر به تأمین آن هستند.
در بارهای کاری سنگین، سرور بهینهشده نقش مُخِ اصلی را ایفا میکند: وظایف را صفبندی و حافظه رم را میان Jobها تقسیم میکند و جلوی قفل شدن سیستمعامل زیر فشار ناگهانی I/O دیسک را میگیرد.
پلتفرمهای برتر مدیریت Batch Job
برای مدیریت صدها پردازش همزمان و زمانبندی دقیق آنها، سرورها از مدیریتکنندههای تخصصی استفاده میکنند:
- AWS Batch و Azure Batch: پلتفرمهای ابری بینالمللی که ماشینهای مجازی را براساس حجم صف بهطور خودکار کموزیاد (یا Auto-scale) میکنند.
- Slurm: مدیر صف فوقالعاده قدرتمند و متنبازی که در اکثر ابررایانهها و کلاسترهای دانشگاهی/مهندسی برای مدیریت پردازش دستهای دادهها استفاده میشود.
اجرای محلی (On-Premise) در برابر ابری
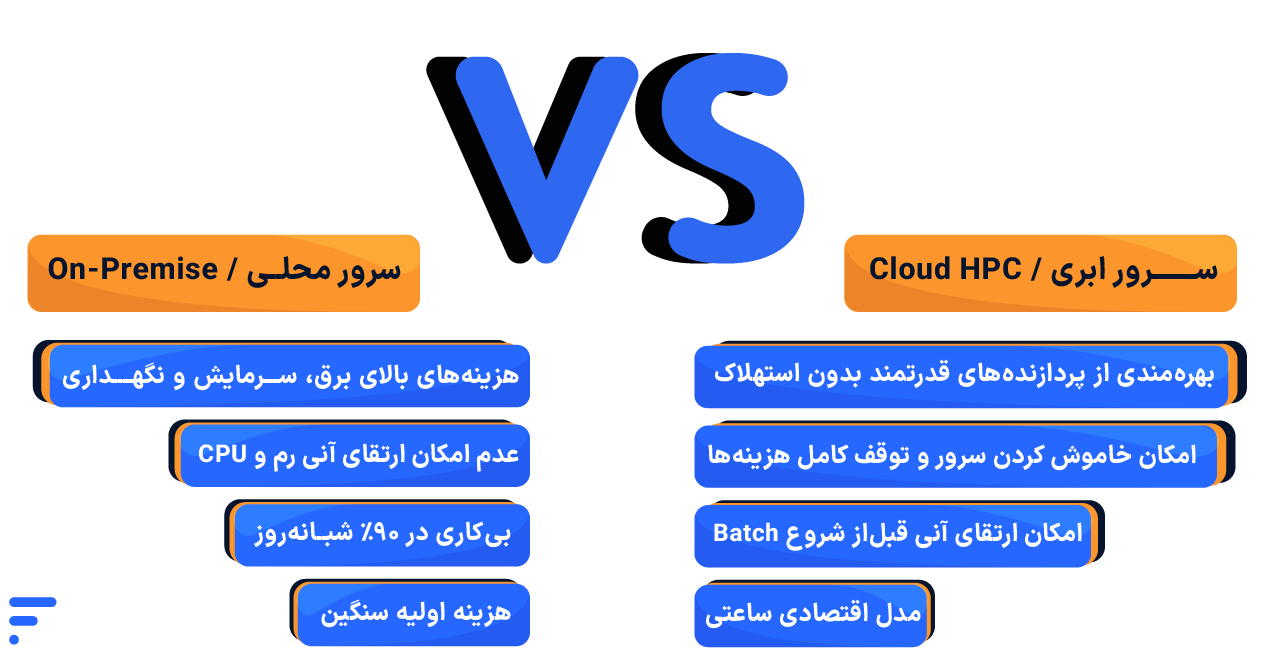
در گذشته سازمانها مجبور بودند سرورهای فیزیکی گرانقیمتی خریداری کنند که ۹۰ درصد روز بیکار بودند و فقط در ساعت اجرای Batch Job به ۱۰۰ درصد مصرف میرسیدند. اما امروزه در مدل ابری، شما سرور محاسباتی را دقیقاً برای همان ساعاتی که پردازش طول میکشد اجاره میکنید و پساز پایان کار، آن را خاموش میسازید تا هزینههای زیرساختی بهحداقل برسد.
پردازش Batch در پایتون
زبان پایتون بهدلیل داشتن کتابخانههای غنی، محبوبترین ابزار برای آموزش پردازش دستهای دادهها است. اما در این زبان اگر بخواهید یک فایل چند گیگابایتی را بهیکباره با پایتون درون حافظه RAM بارگذاری کنید، برنامه شما قطعاً با خطای Memory Error یا کرش ناگهانی مواجه میشود. راهکار اصولی، تکهتکه کردن دادهها (Chunking) و پردازش Batch است.
نمونه کد مفهومی از پردازش تکهتکه فایل با Pandas
در کد زیر، یک فایل CSV بزرگ را به بستههای ۱۰,۰۰۰ تایی تقسیم میکنیم، عملیات پاکسازی را روی هر دسته انجام میدهیم و خروجی را ذخیره میکنیم:
import pandas as pd
# تعیین اندازه هر دسته (Batch Size)
chunk_size = 10000
output_file = 'cleaned_dataset.csv'
# خواندن و پردازش دستهای فایل بزرگ بدون پر شدن RAM
for i, chunk in enumerate(pd.read_csv('huge_dataset.csv', chunksize=chunk_size)):
# ۱. انجام محاسبات، فیلتر یا پاکسازی روی هر دسته
processed_chunk = chunk.dropna()
# ۲. درج هدر فقط برای اولین دسته (Chunk اول) انجام میشود
write_header = True if i == 0 else False
# ۳. ذخیره تدریجی خروجی در فایل مقصد (mode='a')
processed_chunk.to_csv(
output_file,
mode='a',
header=write_header,
index=False
)با استفاده از پارامتر chunksize در کتابخانه Pandas، فایل چند گیگابایتی شما بهجای بارگذاری یکباره در رَم به بستههای ۱۰,۰۰۰ تایی تقسیم میشود. همچنین شرط write_header تضمین میکند که فایل خروجی فقط یک سطر عنوان (Header) در ابتدا داشته باشد و سایر بستهها بدون بهمریختگی فرمت به ادامه فایل ضمیمه شوند.
کتابخانههای کلیدی پایتون برای پردازش گروهی دادههای حجیم
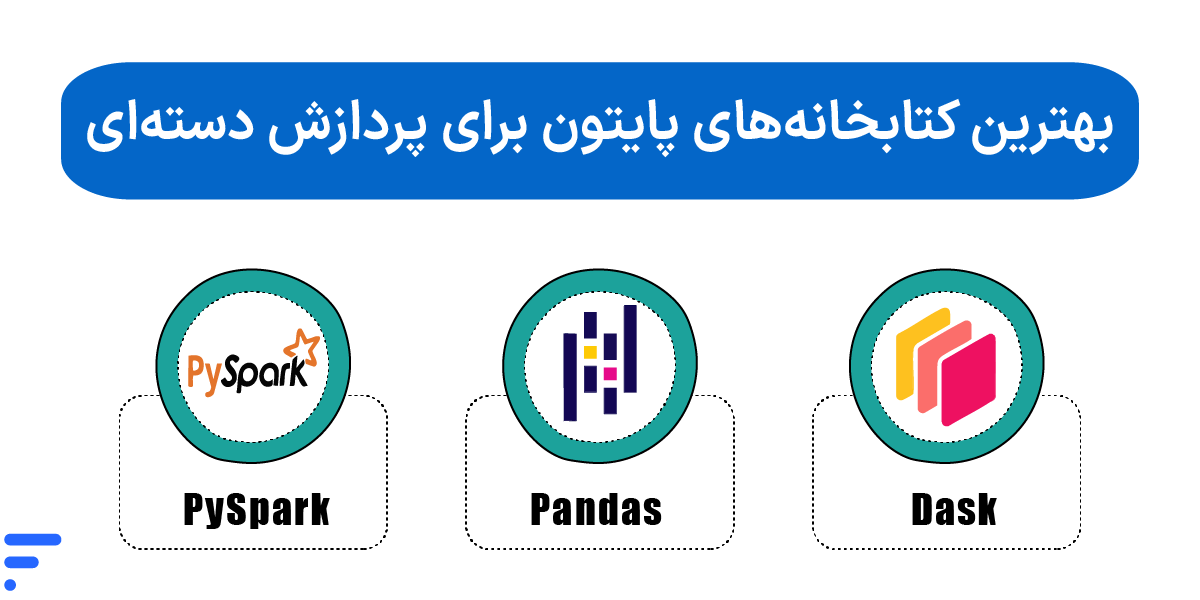
بستهبه حجم داده و نیازمندی پروژه، ابزارهای متفاوتی در پایتون برای پردازشهای دستهای وجود دارد:
- Pandas: عالی برای فایلهای حجم متوسط (چند گیگابایت) با پارامتر chunksize
- Dask: ابزاری فوقالعاده برای موازیسازی پردازشها روی چند هسته CPU، زمانیکه حجم داده از حافظه RAM کامپیوتر بیشتر است.
- PySpark: استاندارد صنعت برای پردازش انبوه داده در مقیاسهای ترابایتی و توزیعشده روی کلاسترهای چند سروری
پردازش دستهای در کلان داده و هوش مصنوعی
در مقیاس کلانداده (Big Data) و مدلهای هوش مصنوعی، اطلاعات آنقدر حجم و تنوع دارند که پردازش لحظهایِ آنها نهتنها ازنظر فنی دشوار است، بلکه هزینههای زیرساختی کمرشکنی ایجاد میکند. در اینجا سیستم پردازش دستهای بهعنوان موتور اصلی تحلیلهای عمیق و دورهای وارد عمل میشود.
تحلیلهای دورهای در کلانداده
در معماریهای کلانداده، ابزارهایی مانند Apache Hadoop (MapReduce) و Apache Spark حجم عظیمی از دادههای ذخیرهشده روی دیسک را در بستههای بزرگ تحلیل میکنند. گزارشهای رفتار مشتریان در طول یک سال، الگوی خرید کاربران در جمعه سیاه یا شناسایی روندهای بازار همگی نمونههایی از پردازش دستهای در کلان داده هستند که بهصورت شبانه یا هفتگی اجرا میشوند.
آمادهسازی داده برای مدلهای یادگیری ماشین (Data Prep)
پیشاز آموزش (Training) مدل هوش مصنوعی، دادههای خام باید پاکسازی، نرمالسازی و تبدیل به ماتریسهای عددی شوند. پردازش دستهای در یادگیری ماشین اجازه میدهد این مراحل سنگین پیشپردازش (Pre-processing) و همچنین مرحله استنتاج گروهی (Batch Inference) روی میلیونها دیتاسِت، بدون اشغال منابع زنده سیستم انجام گیرد.
مقاله مرتبط: راهنمای جامع Fine Tuning مدلهای هوش مصنوعی
تکنیک Micro-batching؛ رابط پردازش دستهای و جریانی
در ابزارهایی مانند Spark Streaming، مفهومی جالب به نام «میکرو-بچ» (Micro-batching) وجود دارد. در این روش، سیستم بهجای پردازش تکتک رویدادها، دادههای ورودی را در بازههای زمانی بسیار کوچک (مثلاً فواصل ۵۰۰ میلیثانیهای) دستهبندی کرده و پردازش میکند. این تکنیک انعطافپذیری و سادگی پردازش دستهای را با سرعت پردازش جریانی ترکیب میکند.
چه زمانی پردازش دستهای انتخاب بهتری است؟
پردازش دستهای دادهها زمانی بهترین گزینه است که اولویت شما بهینهسازی هزینه و پایداری زیرساخت باشد نه دریافت پاسخ در همان ثانیه. اگر پروژه شما مشخصات زیر را دارد، بدون شک باید بهسراغ پردازش گروهی و پیادهسازی آن بروید:
- زمان پاسخدهی حیاتی نیست: اگر کاربر یا سیستم نیازی ندارد که نتیجه پردازش را زیر چند ثانیه ببیند (مثل صدور فاکتور ماهانه یا بهروزرسانی شاخصهای سئو).
- حجم دادهها بسیار بالا است: زمانی که با میلیونها رکورد یا فایلهای چندگیگابایتی مواجه هستید و بارگذاری همزمان آنها سیستم را قفل میکند.
- کاهش هزینه و کارایی اولویت دارد: زمانی که میخواهید بهجای خرید سرورهای گرانقیمتِ ۲۴ ساعته از ساعات خلوتی شبانه استفاده کنید.
- پردازشها تکراری و زمانبندیپذیرند: کارهایی که منطق ثابت دارند و میتوان آنها را طبق برنامه (مثلاً هر بامداد) بدون دخالت انسان سپرد به یک Cron Job.
جدول ماتریس تصمیمگیری (سناریوهای عملیاتی)
جدول زیر نشان میدهد در چه سناریوهای واقعی، ترازو به سمت انتخاب پردازش دستهای سنگینی میکند:
| سناریو و نیاز پروژه | آیا فوریت زمانی دارد؟ | بهترین انتخاب | دلیل فنی و عملیاتی |
|---|---|---|---|
| بازسازی اندکسهای جستجوی سایت | خیر (شبانه) | پردازش دستهای | جلوگیری از کندی جستجوی کاربران در طول روز |
| تأیید تراکنش خرید از درگاه پرداخت | بله (زیر ۳ ثانیه) | پردازش لحظهای | نیاز کاربر به دریافت سریع تأییدیه پرداخت |
| فشردهسازی و واترمارک ویدیوهای آپلودی | خیر (صف پسزمینه) | پردازش دستهای | آزاد نگهداشتن پردازنده سرور برای پاسخ به وبسرور |
| مانیتورینگ و هشدار نفوذ به فایروال | بله (آنی) | پردازش لحظهای | نیاز به مسدودسازی سریع IP مهاجم |
| تولید خروجی مالیاتی و حقوق پرسنل | خیر (پایان ماه) | پردازش دستهای | یکپارچگی محاسبات و عدم نیاز به مانیتورینگ زنده |
انتخاب زیرساخت مناسب برای batch jobها
حتی اگر تمیزترین و بهینهترین کد دنیا را برای سیستم پردازش دستهای خود نوشته باشید، بدون زیرساخت سختافزاری پایدار و مقیاسپذیر، دیر یا زود با بنبست مواجه میشوید. در پردازش آفلاین داده با حجم بالا، سه گلوگاه اصلی وجود دارد که میتواند کل صف پردازش را زمین بزند:
- کمبود حافظه RAM: منجر به بروز خطای Memory Limit یا فعال شدن OOM Killer سیستمعامل و توقف ناگهانی اسکریپت میشود.
- افت سرعت خواندن/نوشتن دیسک: سرور را در زمان پردازش فایلهای بزرگ قفل میکند.
- محدودیت تعداد هسته پردازنده (CPU Cores): باعث طولانی شدن صف اجرا و نرسیدن به پنجره زمانبندی (Maintenance Window) میشود.
یک زیرساخت هوشمندانه باید بتواند نوسانات شدید مصرف منابع را بدون ایجاد اختلال مدیریت کند. وقتی زمان اجرای Job فرا میرسد، منابع باید در بالاترین سطح پایداری در اختیار سیستم باشند و پساز اتمام کار، هزینهای روی دست شما نگذارند.
برای سناریوهای پردازشی سنگین، استفاده از سرورهای معمولی یا هاستهای اشتراکی پاسخگو نیست. در چنین شرایطی، سرور پردازش سریع منطقیترین زیرساخت مهندسی است.
برای درک عمیقتر این زیرساخت، مطالعه مقاله زیر درباره زیرساخت سرور پردازش سریع ابری را پیشنهاد میکنیم
شرکت رایانش ابری فردوسی، این بستر پردازشی را با بهرهگیری از قدرتمندترین سرورهای نسل جدید HPE، پردازندههای AMD EPYC و Intel Xeon و دیسکهای فوقسریع NVMe آماده کرده است تا پردازشهای طولانی و پیچیده شما بدون معطلی و با امنیت بالا اجرا شوند.
مزایای زیرساخت ابری فردوسی برای پردازشهای دستهای
| ویژگی ابر فردوسی | دستاورد عملی برای اجرای Batch Jobها |
|---|---|
| سختافزار پرچمدار HPE و دیسک NVMe | حذف گلوگاه خواندن/نوشتن دیسک و افزایش چشمگیر سرعت اجرای کوئریها و ETL |
| پرداخت ساعتی براساس مصرف | محاسبه ساعتی هزینهها؛ پساز خاموش شدن سرور هیچ هزینهای بابت CPU و RAM نمیپردازید. |
| مقیاسپذیری فوری (Scale-Up لحظهای) | امکان افزایش دهها هسته CPU و گیگابایت RAM تنها با چند کلیک، دقیقاً قبلاز شروع پردازش سنگین |
| منابع کاملاً اختصاصی | ایزولهسازی ۱۰۰ درصدی منابع بدون افت کیفیت ناشی از مصرف سایر کاربران |
| اتوماسیون با کلید API | امکان مدیریت خودکار سرور و روشن/خاموش کردن آن ازطریق اسکریپتها و pipelineهای شما |
برای ارزیابی پایداری و قدرت سختافزاری زیرساخت ما، امکان استفاده از دمو و ۱۰۰ هزار تومان اعتبار رایگان را فراهم آوردهایم تا بتوانید اسکریپتها و پردازش دستهای دادهها را ابتدا کاملاً رایگان آزمایش کنید و سپس با اطمینان خاطر تصمیم بگیرید.
جمعبندی
در این مقاله بررسی کردیم که پردازش دستهای چیست و چرا با وجود توسعه معماریهای آنی، همچنان ستون فقرات سیستمهای مالی، گزارشگیری سازمانی، خطوط لوله ETL و پروژههای هوش مصنوعی است. خلاصه کل مبحث در ۳ اصل مهم زیر جمعبندی میشود:
- زمانبندی هوشمندانه: انتقال محاسبات سنگین به ساعات خلوتی سیستم برای حفظ سرعت و پایداری
- تعادل در Batch Size: تنظیم درست اندازه دستهها برای جلوگیری از سرریز حافظه RAM یا فشار به دیسک
- زیرساخت اختصاصی: جدا کردن محیط پردازشهای آفلاین از دیتابیس زنده برنامه جهت پیشگیری از کندی سایت
حالا شما بگویید که آیا در پروژههای خود از معماری Batch Processing استفاده میکنید؟ بزرگترین چالشی که هنگام اجرای اسکریپتهای زمانبندیشده با آن مواجه شدهاید چه بوده است؟ تجربه یا سؤالات خود را در بخش نظرات با ما به اشتراک بگذارید تا باهم درباره راهکارهای بهینهسازی آن گفتگو کنیم!
منابع:
Confluent | phoenixnap | ibm | geeksforgeeks | pingcap | bmc | aws.amazon | learn.microsoft | rescale
سوالات متداول
پردازش دستهای چیست و چگونه کار میکند؟
پردازش دستهای (Batch Processing) روشی برای اجرای پردازش گروهی دادهها است؛ به این صورت که دادهها در طول زمان جمعآوری و بستهبندی میشوند و سپس در یک زمان مشخص (معمولاً ساعات خلوتی سیستم)، بدون نیاز به دخالت کاربر و بهصورت خودکار پردازش میشوند.
تفاوت پردازش دستهای و پردازش لحظهای چیست؟
تفاوت اصلی در تأخیر (Latency) و نحوه مصرف منابع است. پردازش لحظهای (Real-time) دادهها را بلافاصله پساز تولید با تأخیرِ زیرِ چند ثانیه پردازش میکند و نیاز به سرورهای همیشه روشن دارد؛ اما پردازش دستهای دادهها را در فواصل زمانی مشخص و بهصورت تجمیعی با هزینهای بسیار کمتر تحلیل میکند.
کاربرد پردازش دستهای در سرورها چیست؟
در مدیریت زیرساخت سرور، برای اجرای کارهای سنگین و تکراری مانند بکاپگیری خودکار دیتابیس، چرخش فایلهای لاگ (Log Rotation)، بهروزرسانیهای امنیتی و اجرای فرایندهای انتهای روز (End-of-Day) استفاده میشود تا منابع سرور در ساعات کاری و پرتردد آزاد بمانند.
منظور از پردازش دستهای در کلان داده چیست؟
در این حوزه، ابزارهایی مانند Apache Spark و Hadoop از این متدولوژی برای تحلیلهای عمیق، گزارشگیریهای دوره ای و اجرای کوئریهای سنگین روی حجمهای ترابایتی و آرشیویِ داده استفاده میکنند؛ موقعیتی که دریافت پاسخ در همان ثانیه اهمیتی ندارد.
Batch Processing در هوش مصنوعی چیست؟
در یادگیری ماشین و هوش مصنوعی، برای مراحل پیشپردازش دیتاستهای غولپیکر (Data Preprocessing) و همچنین استنتاج دستهای (Batch Inference) به کار میرود. این روش مانع از پُر شدن ناگهانی حافظه VRAM کارت گرافیک یا RAM سرور در طول فرایند آموزش مدل میشود.
آیا پردازش دستهای ارزانتر از پردازش لحظهای است؟
بله، بهشدت. در پردازش لحظهای شما مجبورید سرورهایی با منابع بالا را بهصورت ۲۴ ساعته رزرو نگهدارید. اما در پردازش دستهای میتوانید از مدلهای ابری ساعتی استفاده کنید و سرور پردازشی را فقط برای همان ۱ یا ۲ ساعتی که اسکریپت درحال اجرا است روشن نگه دارید.
بهترین ابزارها برای زمانبندی و مدیریت پردازش دستهای کداماند؟
برای اسکریپتهای ساده لینوکسی، Cron Job بهترین ابزار است. در پروژههای پایتونی معمولی، Celery و در خط لولههای پیچیده مهندسی داده، Apache Airflow یا Slurm (برای سرورهای محاسبات سنگین) بهترین محسوب میشوند.
چگونه خطاها را در سیستمهای پردازش دستهای مدیریت کنیم؟
با استفاده از تکنیک «صف دادههای خطادار (Dead-Letter Queue)» و تراکنشهای Atomic. اگر یک رکورد درون یک بسته خراب باشد، سیستم باید آن رکورد را کنار گذاشته یا کل بسته را Rollback کند و خطا را به یک فایل لاگ جداگانه بفرستد تا کل جریان پردازش متوقف نشود.
آیا پردازش دستهای با پردازش آفلاین داده یکسان است؟
از نظر مفهوم بله؛ هر دو به فرایندهایی اشاره دارند که به پاسخدهی زنده به کاربر وابسته نیستند. بااینحال، کلمه Batch صریحاً بر گروهبندی و دستهبندی دادهها پیشاز شروع محاسبات تأکید دارد.